
你的资料不是没收藏,是收藏了找不到
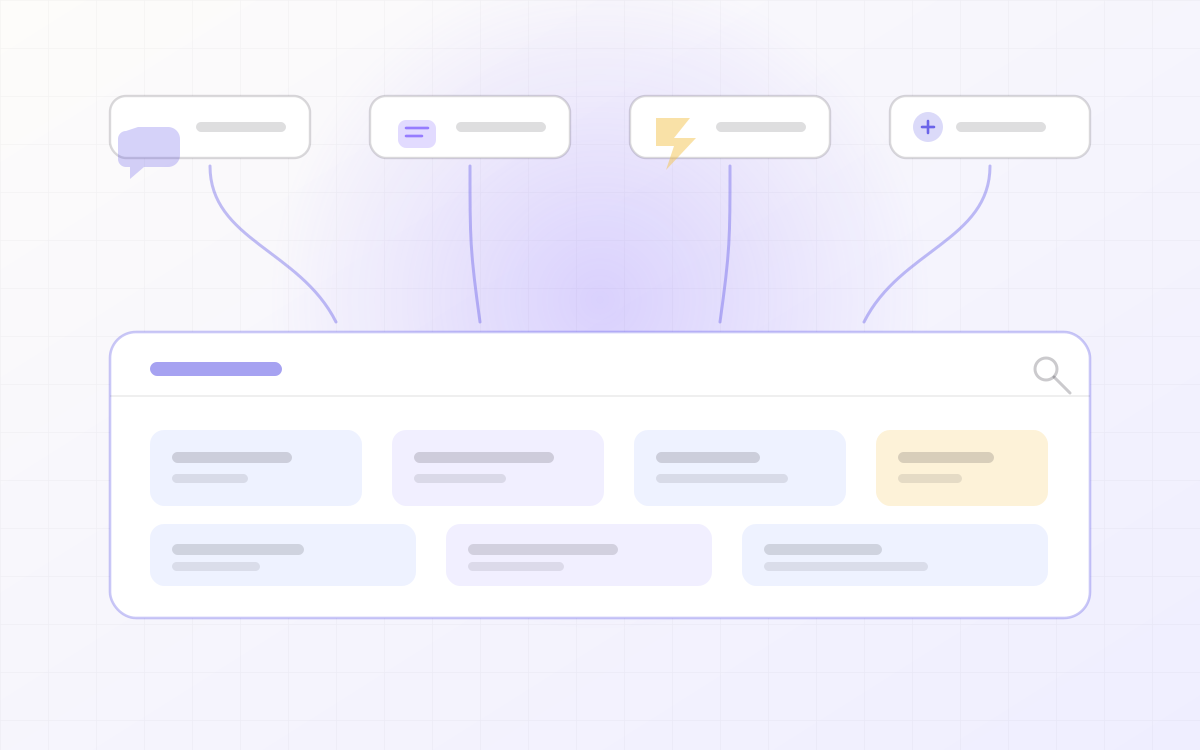
微信收藏、浏览器书签、下载目录、聊天记录——资料散在四个 App 里,真要找的时候只剩一句「上次那个结论在哪?」这篇讲归位这件事:四个入口、一个归宿,收进来就能问。
大多数人不是不收藏,是收藏得太散。
微信收藏夹里躺着几百条,浏览器书签栏挂着大半屏,下载目录里堆着几个 G 的 PDF,还有一堆截图散在相册。真要找的时候,脑子里只剩一个问题:「上次那个结论在哪?」
然后你花二十分钟翻,最后重新搜一遍。
收藏是一秒钟的事,归位才是难的
保存只要一次点击。但决定三个月后还能不能找到的,不是保存那一下,而是保存之后它去了哪、带没带上「能被找到」的信息。
大多数工具默认你一次只用一个来源:要么处理网页,要么处理文件,要么处理对话。可你的资料从来不是这么来的。
四个入口,一个归宿
你现在大概在四个地方各自收藏:
- 大模型对话——那次跟模型掰扯半天才得到的结论,关掉标签页就没了。
- 网页——看到了好文章,存进书签栏,从此再没打开过。
- 文件——PDF、Word、PPT、图片,下载完放在某个文件夹里,靠文件名回忆内容。
- Agent 会话——用 Cursor、Claude Code 这类工具干活跑出来的长会话,比对话更值钱,也更容易丢。
这四个入口对应四种完全不同的来源。收进来之后,它们应该长得一样:都有标题、有来源、有时间、有能被检索的正文。
这一步做了,才算「归位」;没做,只是又换了一个地方堆。
收进来,就该能问
归位之后最实际的变化是:你不用再「读完」,可以直接问。
问法上有条经验值得记下来——要求它引用原文,而不是总结原文。总结你没法验证,原文可以。
- ❌「这份合同有什么问题?」——范围太大,答案只能泛泛而谈。
- ✅「第 4 条和第 9 条对违约责任的表述是否冲突?引用原文。」
- ✅「把支持这个结论的段落原文抄出来,标页码。」
在 LLM-notebook 里,回答里的每个结论都带标号,点一下跳回原文对应段落并高亮。所以验证一个结论要五秒,不是五分钟——这也是为什么「有出处」比「答案漂亮」重要得多。
真正决定价值的,是「用过几次」
仓建得再大,一直没动过就等于没有。三个小习惯,回报比收藏本身大得多:
- 收藏时补一句自己的话。 三个月后你会感谢现在的自己——原文档不会告诉你当初为什么留着它。
- 用文件夹分层,标签留给跨主题的关键词。 两者分工别混:文件夹回答「它属于哪」,标签回答「它跟什么有关」。
- 收藏完立刻问一个问题。 这一下把它从「存着」变成「用过」。存着的东西会过期,用过的东西才长在你身上。
我们不做的三件事
说清楚边界,比堆功能更有用:
- 不做网盘。 这里不是备份硬盘的地方,是「能被提问」的地方。
- 不做笔记社区。 你的素材不需要被别人点赞。
- 不陪你聊天。 它不是陪伴型产品,也没有角色扮演。
代价也说清楚:空仓问不出好答案。 这里奖励一点点收集的习惯,不奖励「先装个工具再说」。
收藏是动作,归位是能力。找得到的,才算资产。
怎么开始
装好浏览器插件或 skill 之后,上面这些都在你原本的工作流里,不需要再开一个页面。真正值得做的第一步很小:先收三份你最近真的用过的资料进来,然后问它一个问题。
继续读
 产品思考
LLM-notebook 和 Gemini Notebook(原 NotebookLM)到底哪里不一样
两者建立在同一个前提上——回答只依据你给的资料。但从「收什么进去」到「产物能不能改」,走的是两条路。这篇把可核实的差别列清楚,也说明什么情况下该选它。
阅读全文 产品思考
插件与 skill:装哪条、怎么装、卡住了怎么办
两条接入路径,解决的问题不一样:插件负责「收」,skill 负责「用」。这篇按你卡在哪一步来分流,并把三个最常见的卡点写清楚。
阅读全文 产品思考
为什么我们不做一个「更好用的聊天框」
聊天框是所有 AI 产品的默认形态,也是它的天花板:上下文即用即弃,结论留不下来。这是我们的取舍记录。
阅读全文