返回博客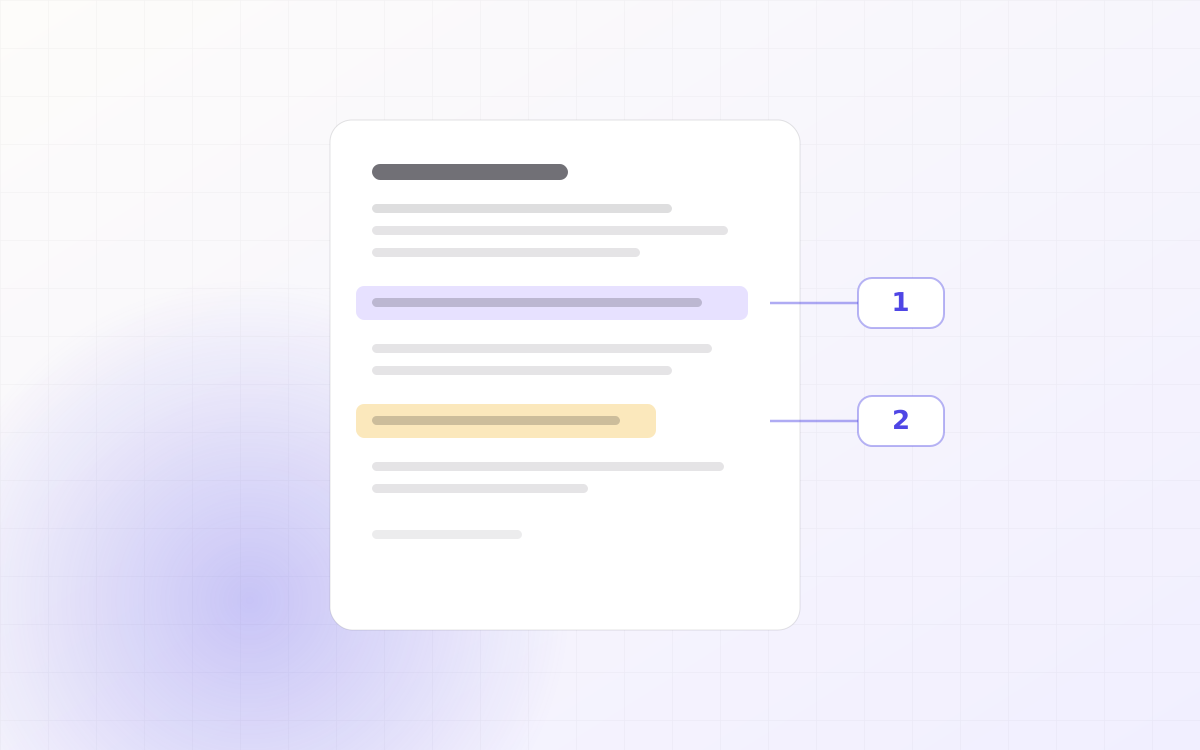
基于文件提问:让每个结论都带出处
把 PDF 丢给模型问一句「这份合同的风险点在哪」,答案能不能用,取决于它有没有告诉你「风险点在第 7 页第 3 段」。
大模型回答问题时最大的问题不是错,而是你没法验证它错没错。
从「看着像」到「翻得到」
在 LLM-notebook 里提问,回答里的每个结论都带标号:[1]、[2]。点标号会跳回原文对应段落并高亮。
这意味着两件事:
- 你可以花 5 秒验证,而不是花 5 分钟重新读一遍。
- 你可以在把结论写进方案前,先确认它没被断章取义。
问题怎么问,答案才落地
同一份素材,问法不同,可验证性差很多:
- ❌ 「这份合同有什么问题」——范围太大,答案只能泛泛而谈。
- ✅ 「第 4 条和第 9 条对违约责任的表述是否冲突?引用原文。」——能直接验证。
- ✅ 「把支持这个结论的段落原文抄出来,标页码。」——逼模型回到原文。
一个好用的经验:要求它引用原文,而不是总结原文。总结无法验证,原文可以。
引用是产品能力,不是提示词技巧
很多工具也能「带出处」,区别在于出处是模型生成的,还是系统从解析结果里取的。
我们走的是后者:素材解析时就保留了段落与页码,回答时把标号绑到真实段落上。所以标号不会指向一个不存在的页码——它要么跳得过去,要么就不该出现。
引用不是为了让答案好看,是为了让你敢用。