
收、问、改、出:一份素材走完的一次完整流程
从「存下来」到「用出去」中间那一段最难。这篇把它拆成五步走一遍:收 → 问 → 改 → 出 → 讲,每一步都说清为什么这样做,以及最容易做错的地方在哪。
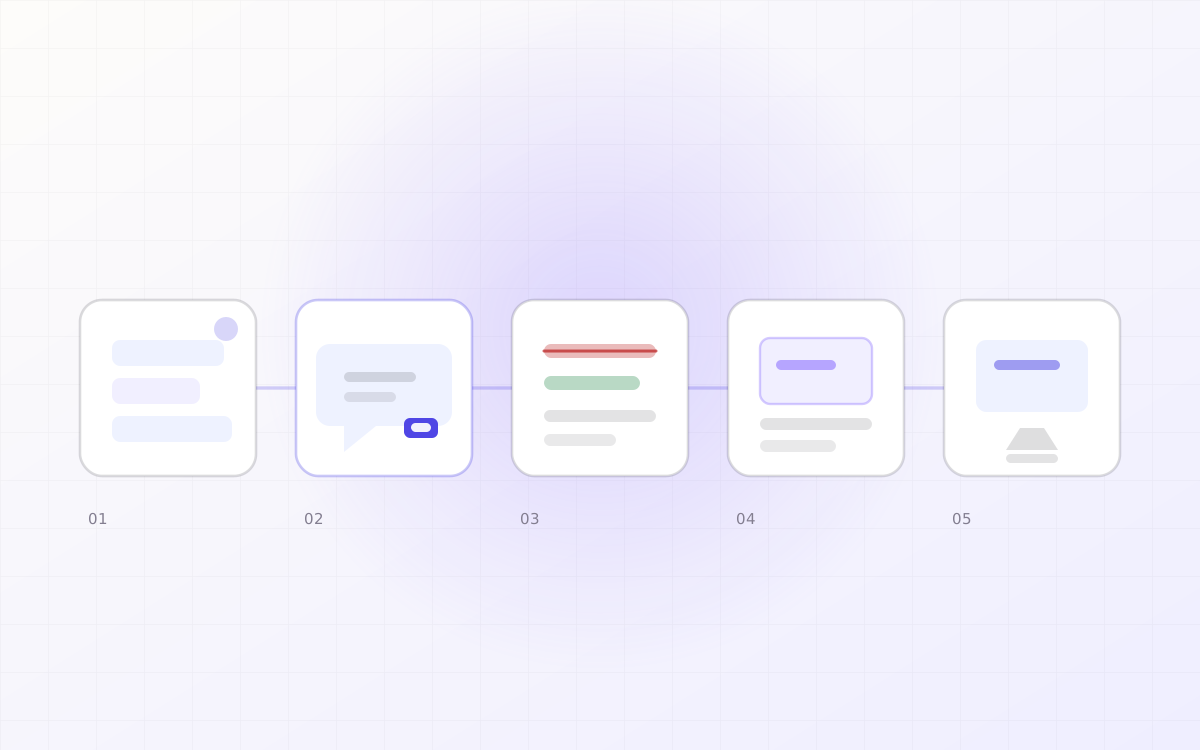
收藏动作本身没有门槛,难的是「存下来」到「用出去」中间那一段。
这篇把这一段拆成五步走一遍:收 → 问 → 改 → 出 → 讲。每一步我都会说清为什么要这样做,以及最容易做错的地方在哪。
第 0 步:先选一份你真的要用的资料
不是「以后可能有用」,是这周就要交出去的东西。
这一步很重要,因为整条流程的产出质量,取决于原料是不是真的和你手上的事有关。先从一份开始,别一次整理三年。
第一步 收:把这份东西的原料收齐
一份材料很少只有一个来源。它可能是一份 PDF 报告、两个网页、加上你上周跟模型讨论出来的一段结论。
四类入口都能收:大模型对话(在聊天页点「收藏对话」)、网页链接(粘贴 URL)、文件(拖进去)、Agent 会话(让它收藏当前会话)。收进来之后它们长得一样:有标题、有来源、有时间、有能被检索的正文。
为什么先做这一步: 原料不齐,问出来的答案就是残缺的——而且你往往不知道它缺了哪一块。收齐是唯一能让你「知道自己在问什么」的办法。
第二步 问:要它引用原文,不要它总结原文
这一步只有一条经验,但值得单独讲:
要求它引用原文,而不是总结原文。
总结你没法验证;原文可以。同一份材料,问法不同,可验证性差很多:
- ❌「这份合同有什么问题?」——范围太大,答案只能泛泛而谈。
- ✅「第 4 条和第 9 条对违约责任的表述是否冲突?引用原文。」
- ✅「把支持这个结论的段落原文抄出来,标页码。」
回答里的每个结论都带 [1]、[2] 这样的标号,点一下跳回原文对应段落并高亮。
为什么这一条最关键: 它把「我觉得这段可以信」变成「我看见它在原文哪一句」。五秒能验证的结论,你才敢用在工作里。
第三步 改:不要推翻重写,逐块提意见
选中不满意的那一段,把它加进对话,然后说一句你的意见——比如「这段太啰嗦,压到两行」。
注意它不会直接改你的文件。它给的是一份逐块提案:原文和改后并排,红的是删除、绿的是新增,你逐块采纳或拒绝,也可以继续提意见让它重出。
为什么这样做: 改稿真正的成本不在「写」,在「找差异」——你总得知道这一版和上一版到底差在哪。把它变成逐块采纳之后,改稿就更像看代码的改动记录:可以局部接受,也可以整块退回。
第四步 出:让它变成能交出去的形态
确认过的内容,再落成产物:
- 笔记:临时查出来的结论、一段可以复用的说明,直接存成笔记,之后能改。
- 思维导图:结构复杂、需要一眼看清层级的时候用。
- PPT:要讲给人听的时候用。生成出来的是可编辑对象(文本框、形状、图表各自独立),能导出 pptx,素材里的数据点保留出处。
为什么强调「可编辑」: 一份不能改的产物,你迟早要重做一遍。能改、能导出的,才是你交得出手的东西。
第五步 讲:把出处留着
汇报时最常被问到的一句话是「这个数字哪来的」。
因为数据点是从素材里带出来的,出处一直在——你能当场答出来,而不是回头翻半小时。
为什么这一步值得单独说: 前面的每一步,最终都是为了让你在被人问住的时候答得出来。
最容易做错的三处
- 收的时候不留一句话。 三个月后你会看着这条素材想不起来当初为什么留它。
- 问得太宽。 「帮我看看这份材料」几乎一定会得到一个正确但没用的答案。
- 想一次到位。 直接要最终稿,你只能得到一个要重做的版本;先要大纲或初稿,再逐块改,反而更快。
你今天就能做的一次
从最小的一次开始:
- 收三份你真的用过的资料(其中至少有一段 AI 对话);
- 问一个具体的问题,要求它引用原文;
- 挑出其中一处不满意的地方,逐块改掉;
- 把结果存成笔记。
四步走完,你就有一条自己的流程了——之后只是把原料换成新的。
收藏是往里放,流程是往外拿。能拿出来的,才算你的。
继续读
 再创作
从素材到 PPT:一次生成、能改、能导出
生成一份 PPT 不难,难的是生成之后你还愿意用它。我们花了更多力气在后半段:可编辑、可导出、版式不塌。
阅读全文 产品思考
LLM-notebook 和 Gemini Notebook(原 NotebookLM)到底哪里不一样
两者建立在同一个前提上——回答只依据你给的资料。但从「收什么进去」到「产物能不能改」,走的是两条路。这篇把可核实的差别列清楚,也说明什么情况下该选它。
阅读全文 产品思考
你的资料不是没收藏,是收藏了找不到
微信收藏、浏览器书签、下载目录、聊天记录——资料散在四个 App 里,真要找的时候只剩一句「上次那个结论在哪?」这篇讲归位这件事:四个入口、一个归宿,收进来就能问。
阅读全文